跳到主要内容

37 篇博文 含有标签「科技」

查看所有标签

微波炉的进化史

· 阅读需 1 分钟

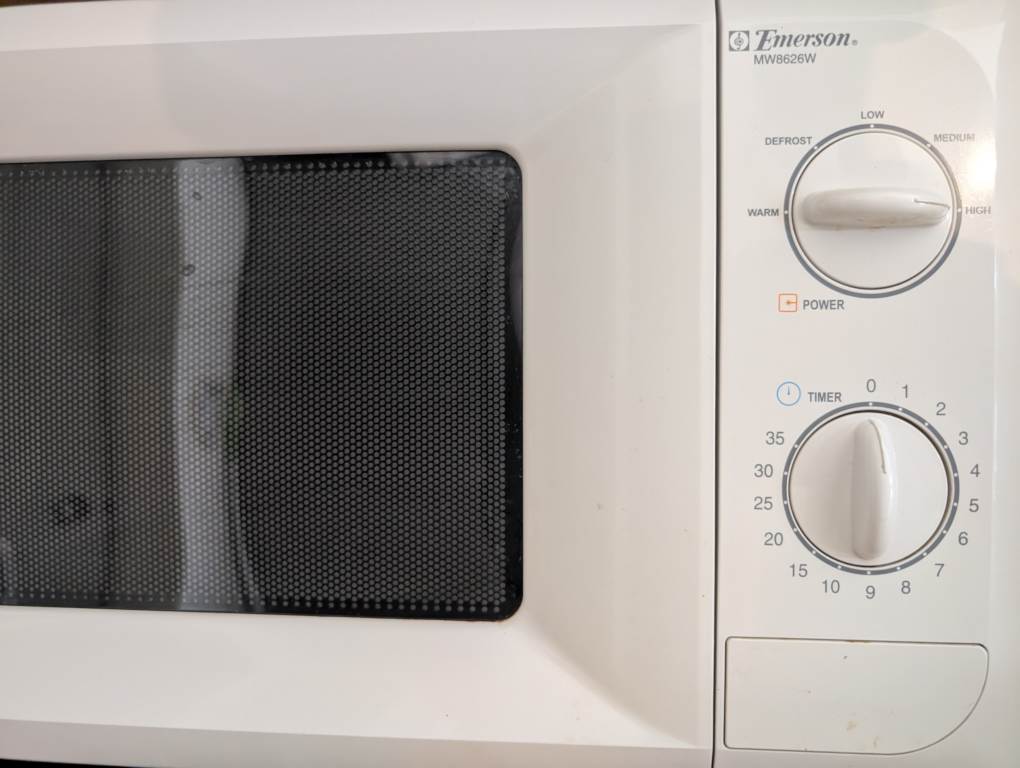
十几年前搬到新家的时候,前屋主留了一个很原始的微波炉,大概长得像这样:

Old Oven

两个旋钮,一个调火力,另一个调时间,没有任何「其他」功能。

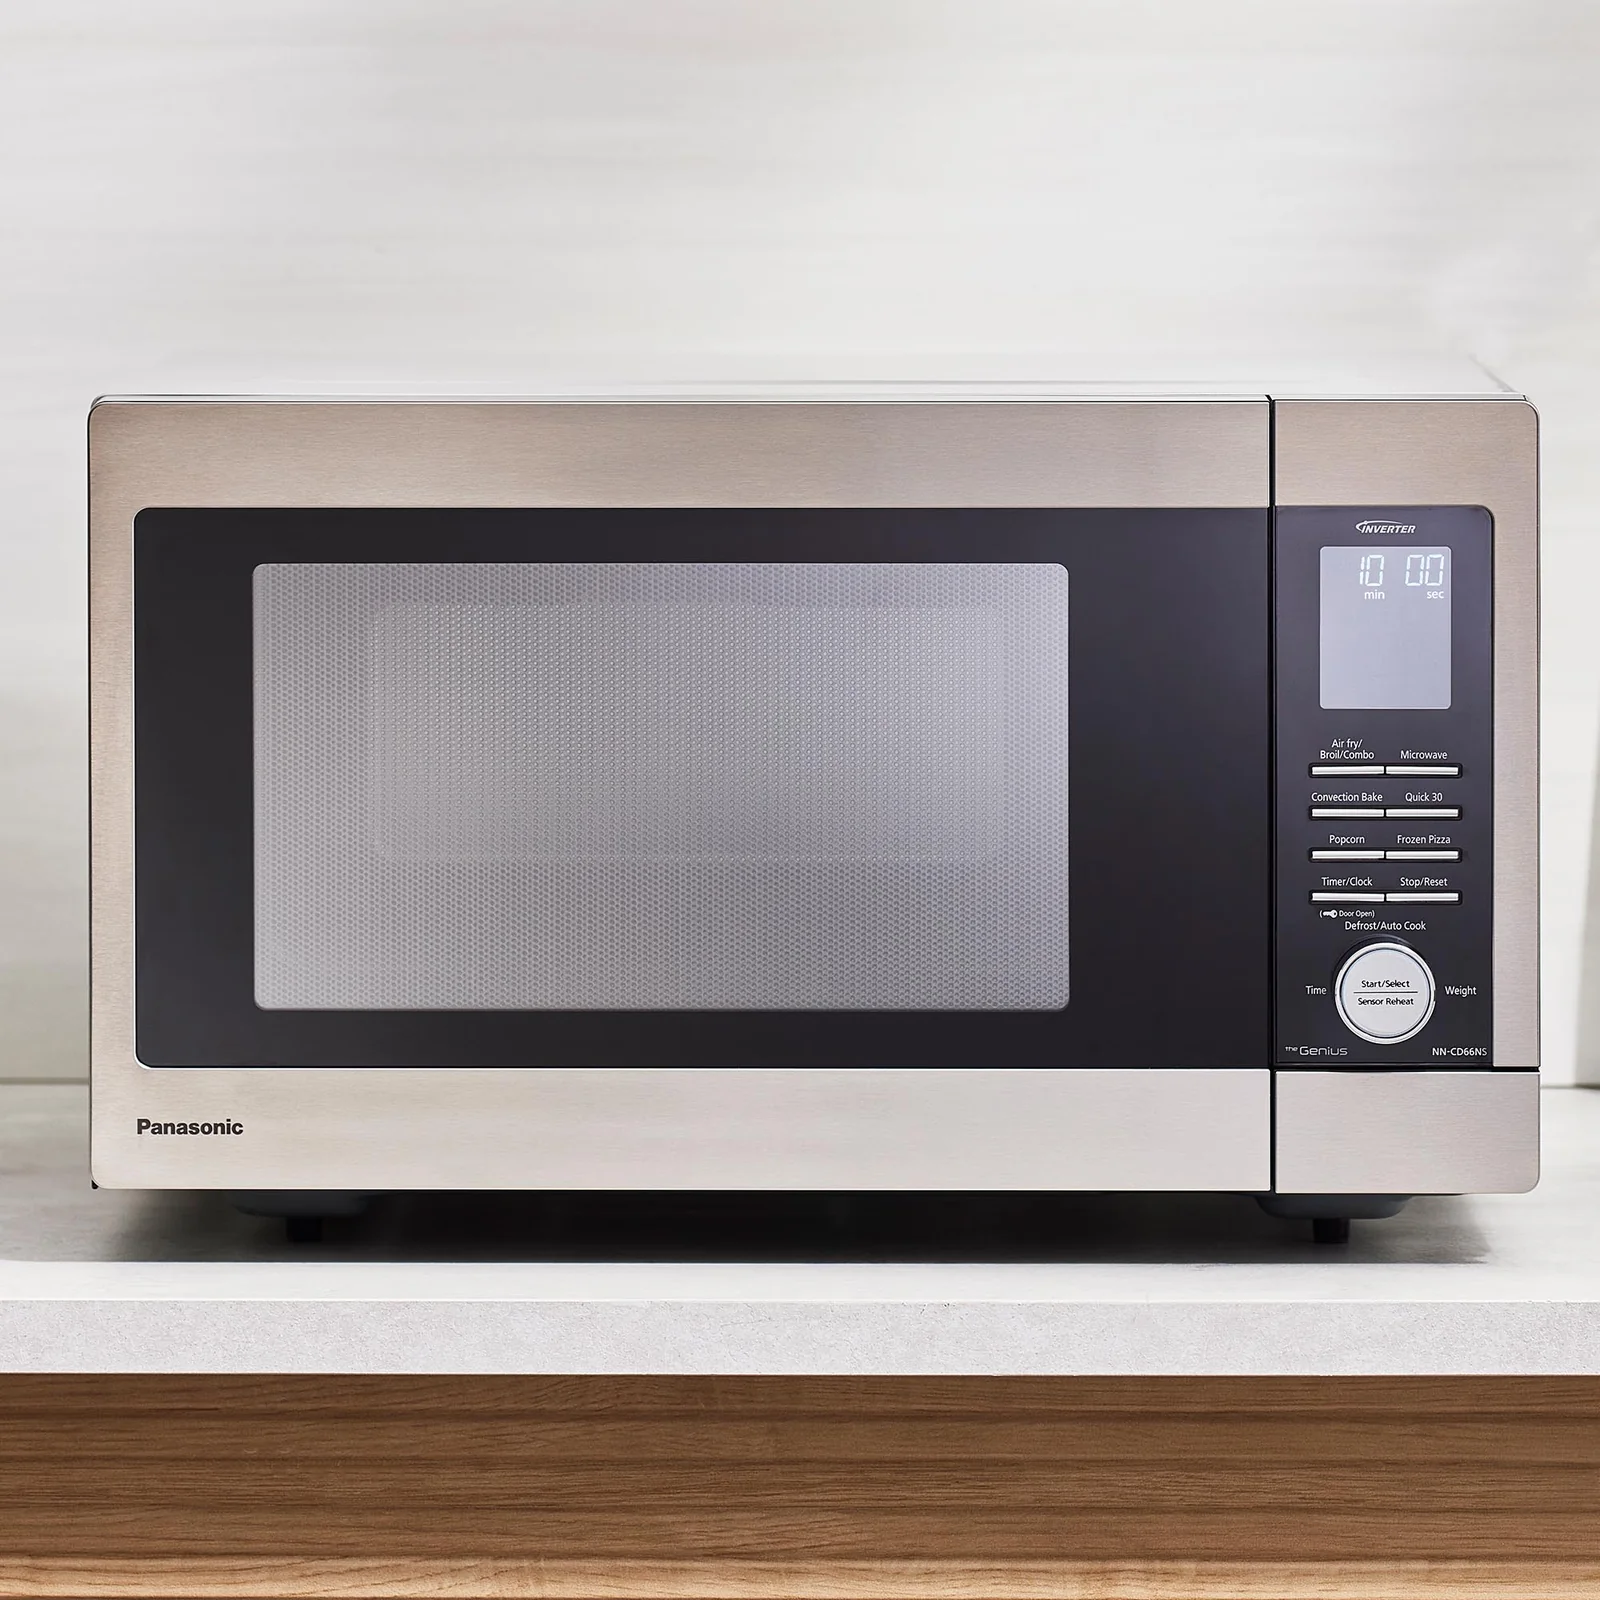
这么破的微波炉,我们当然是看不上啦。于是买了一个比较现代的微波炉:

New Oven

(具体不是这款,但是也类似吧。)

新款的微波炉,有好多功能,比如可以

  • 根据食物的重量自动选择解冻时间
  • 鸡肉和牛肉有不同的程序
  • 能显示时间,还能设定倒计时
  • ……

以上的功能我们一次都没有用过。

但是,如果要加热 5 分钟,需要使劲按「5」「0」「0」「Start」,按错了还要删除。用了没两年,那个显示屏突然就不工作了——非但时钟显示不了,连基本的加热功能也坏掉了。

于是我们只能搬出那个十几年前的微波炉,开门、转一下,不用半秒钟就开始加热了。

以上就是「微波炉」这种科技的进化史。

渐渐失控的服务器群

· 阅读需 2 分钟

昨天发现 immarcus⎈setusfree.net 其实已经有一个多星期不工作了 💀 检查一圈发现是因为我用 SyncThing 来同步的 SSL 证书突然发生了文件冲突。想做进一步检查时才发现,我居然完全找不到哪台服务器负责更新 setusfree.net 证书(所以感觉这个域名随时有可能再挂掉……)

重启了一些服务器之后,发现我的 addy.io 也连不上了,Tailscale 也有点摇摇欲坠的趋势。我又对现在 LXD 分割服务器的做法不是很满意,于是内心又产生了「一锅端从头来」的冲动。

自从我用 Claude 建了一个用来跑多智能体的 k3s 集群之后,我对于运维的兴趣进一步下降了。k3s 真的是太繁杂了,虽然看着 AI 写一堆 yaml 文件大概是理解背后的逻辑,但是要我学习 Kubernetes 的语法,手搓各种配置文件,我真的是一点兴趣也没有……

现在正在纠结是不是要彻底折腾一番家庭服务器,把 LXD 端掉,用 AI 部署一个 k3s 集群,把家里所有的服务器和 VPS 都集中管理起来。

但我不懂 k3s 啊 😫

当智力成为廉价品

· 阅读需 6 分钟

「AI 让智力成为了廉价品」——这是一句现在很流行的话。前几次工业革命让人的体力劳动成了廉价品,后几次工业革命又要让人的智力变得一无是处,现在的 AI 焦虑大概就是这个逻辑。

那么顺着这种逻辑说,如果 AI 真的让智力成为了廉价品,还有没有什么不是廉价的呢?

如果万事都变成廉价品,那么共产主义就实现了。好吃懒做的人类靠着太阳光转成电能再转成 Token,就可以躺着享受熵减的红利……哪有那么好的事情——如果那一天真的到来了,人类这种寄生蛀虫肯定会被真正实现熵减功能的 AI 淘汰掉。所以我不愿意相信「万物都是廉价的」这种说法,也就促使我试图找出会变得越来越贵重的东西。

体力劳动​

初中学历的人都知道「物质不灭」定律,也就是说,靠我们的体力劳动,我们其实创造不出任何东西,也毁灭不了任何东西。人类劳作的本质,是「分离」和「重组」——这就是最近老生常谈的「熵减」活动。人的体力劳动,就是照着人的需求,把环境中高熵的事物变成低熵的事物。任何劳作的本质,和「老奶奶坐在凳子上拣菜(把好的和坏的区分开)」是同一个原理。

这里有一个前提,那就是要有事物。一个体力无限,还拥有先进工具的人,如果是漂浮在外太空,那么他也永远无法生产出任何价值,因为周围没东西可以让他来「分离」和「重组」。

第一次工业革命,让人的体力劳动大大贬值。机器拥有巨大的「体力」,于是生产原料就成了生产环节中的瓶颈。

智力劳动​

很明显,「智力」与体力是完全对应的概念,也只是一种能力,要有产出的话还必须要有处理的对象——那就是「信息」。

信息被加工过之后,就会失去其价值。新闻爆出来之后,股市就会立刻消化这个信息。虽然报纸还在那里,信息的价值已经不在了。

我们很容易忘记信息的珍贵。如果我们能提前十五分钟知道美国放弃轰炸伊朗的话,就能挣好几个亿。1早期的互联网的确造就了信息大爆炸,世界各地的信息可以以毫秒级的延迟传互相传输。那时信息产生和传播的速度远超我们的处理能力。现在 AI 突然让情报处理能力得到了飞跃,但问题是,信息的宿命会是如何?生成式 AI 边吃边拉的特点,让流通在外的独立信息变得极度稀缺,信噪比大降。虽然巧妇有了全自动多功能智能 AI 电饭煲,但是市面上能买到的米,一大半都混着有毒的杂质,生产力就一定会单调递增吗?

信息的来源​

那么具有生产价值的「原料信息」是从哪里来的呢?其实回过头去对比一下「体力劳动」这个范畴就能找到线索。

「体力劳动」对应物理世界的范畴,原料的开发就是第一产业——农矿业。也就是说,我们只是等待太阳光被叶绿素转化后成自然界的能量,我们再去采集。但是信息的来源不太一样,毕竟自然界没有什么可供采集的信息(例如,「天气」作为自然界的随机性虽然很重要,但 Google 绝对不可能靠做天气预测来挣大钱)。于是,仔细想想的话,信息的来源就是「我们」——「人」!

人的思想变幻莫测,尤其是「温饱」之后的「淫欲」千奇百怪。我完全无法想象 Labubu、球鞋、NFT 这些东西居然在人类社会里有这么大的需求!这些需求都是极其「随机」的,而越是随机不可预测的东西,蕴含的信息量也就越大。

这就是「信息产业」的本质逻辑——在温饱问题被解决的社会里,人会产生各种无法预测的随机性(也就是信息)。把这些信息收集起来,用「智力」进行处理之后,就能产生对整个系统有「熵减」价值的贡献了。这就和农作物水分肥料吸到足了以后就开始结果实是一模一样的机理。

当智力成为廉价品​

其实所有的思维要素都已经被列出来了。当智力成为廉价品之后,社会会是什么光景?

我在美国的健身房里遇见过无数的肌肉猛男,但是他们的工作几乎没有和体力相关的。智力成为廉价品之后也是一样——特别聪明的人,可能就跟身材特别好的人一样,还是会招人羡慕,但是智力已经跟求职的能力完全不挂钩了,反而更可能是成为倒贴钱的娱乐项目。

那么,人的体力和脑力都被废了,难道还有剩什么吗?我认为这里就是困住大多数人的误区——人的能力,不是「体力」和「脑力」这么二元分割的。仔细想想,有没有什么能力是可以赚大钱,但并不一定要求人很强壮或者很聪明的呢?

有啊!我至少能想到两种:

  1. 情感能力:能共情,有魅力,有领导才能,会察言观色……这样的人并不一定是最聪明的、懂的最多的,但是有许多人就能在团队中发挥巨大的作用。
  2. 担责能力:有魄力,能抗风险,有原则,能作道德判断……这样的人也不一定是聪明的,甚至需要有一股「楞劲儿」。无论是在投资,还是在政治、法律等领域里都能有卓越的贡献。

总之,AI 能替代的,并不是「体力劳动之外的一切劳动」。当智力被 AI 大量替换之后,智力仍然会像健硕的体魄一样被人类所追求,而工作岗位则会继续向着正交的方向继续生长出去。

也不要忘了另一面:人类仍将继续担任「信息庄稼」的韭菜角色,被智力来收割。但是我预期这种收割会变得越发精准,而一切泛泛收集数据的手法都会失效,因为像互联网这样的公共领域将被 AI 污染得体无完肤。关于这一点,我想从我很早写的一篇名为《信任危机》的文章最后直接复制两点过来:

  • 把隐私看作是自己重要的资产——哪怕到了某一天你不得不出卖自己的隐私,屯到最后一定能卖最高的价格;
  • 学会享受周围人的不待见——「你太落伍了」「你太极端了」……这些决定是我深思熟虑过的,我完全不需要这些便利;我宁愿在镰刀割来的时候,稍稍辛苦一下我微微弯曲的膝盖。
Footnotes​

  1. https://www.independent.co.uk/news/world/americas/us-politics/trump-iran-oil-insider-trading-war-b2945169.html ↩

Ubuntu 变味了

· 阅读需 2 分钟

一个营利性公司支撑的自由软件迟早要变味,我对这一点倒是很早就做好了心理准备。按照我的标准,最近 Ubuntu 终于到了「三振出局」的地步,我要开始积极寻找替代方案了。

第一是 Snap 商店的半闭源特性(商店服务器并不是开源的)。加上这个玩意儿一直作为一个守护进程运行着,感觉就是怪怪的。Snap 从技术上来说就是一个重复造轮子,并且只有 Canonical 一家在大力推崇,让我不得不联想到 Apple 和 Google 那种靠建立应用商店赚钱的商业模式。

第二是 LXD 的「私有化」。LXD 是一个 Linux 容器管理平台,和 Proxmox 比较像。这个项目被 Canonical 完全接管后,就变得很「私人」的感觉,比如只能通过 Snap 商店安装(也就意味着为了 LXD,我的系统就必须要运行 snapd)。Canonical 又对 LXD 大刀阔斧地改造,去掉了很多「没用的」功能,加入了很多「私有的企业级角色」。

上周让我对 Ubuntu 态度彻底改变的是在 apt upgrade 后提示的一段消息,大概的意思是「我们有一些软件包的安全漏洞补丁,但是你要订阅我们的 Ubuntu One Pro 服务才能下载哦~」。我去 Ubuntu 网站研究了一下,发现这个订阅对于个人用户目前是免费的。但是,你要用邮箱注册一个账户,才能获取一个识别码,并且要将识别码绑定到 Ubuntu 系统里。也就是说,最起码 Canonical 会知道哪些服务器是我的,IP 是在哪里——这就给我的味蕾留下一丝细微又醇厚的耗子屎口感。

我自然的投靠对象当然是 Debian(其实我现在的 LXD 主机就是 Debian + Snap 的奇怪组合)。工作电脑也许还会继续沿用基于 Ubuntu 的 ZorinOS,不过服务器端大概是想转到 Kubernetes/k3s 方案下了吧(但不知道这会不会让 Tailscale 变得不好配置)。

如果你有什么好的建议也欢迎来信指导我~🙏

软件架构与成功之母

· 阅读需 4 分钟

今天读到 Eltrac 的 Clean Architecture 读后感,觉得还挺有意思的,于是想插入几句自己的看法。

首先让我感觉有意思的地方是,我没有想到「软件架构」这种东西,如书中所说,真的几乎没有什么进化和改变。比如书里提到的 SOLID 原则和测试驱动的方法,就已经是 OOP 里经典到入土了的教义。

SOLID 原则争议

网上对 SOLID 的批判声是排山倒海,不把经典批倒批臭怎么能展现新生代的酷炫呢?

这里就不展开这个大粪坑了。之后再来掏粪

关于架构的书籍我没有读过很多,但是一个从小学开始就喜欢手搓代码为生的非科班半码农,我对架构的理解就是从一次一次「推倒重建」的血泪经历中建立起来的。在设计软件的早期作出的任何一个小小的偷懒设计,到了后期都会复利增长成巨大的屎山代码。

就拿我目前的工作来说,有一个非常底层的组件就是把一个字符串反解成一套用于初始化各个对象的配置。这套东西的设计经历过几个版本:

  • 最早的时候就是把字符串传来传去,每个对象都去同一个串里找属于自己的字符,代码恶心不堪。
  • 第二套方案,字符串被大致切割,预处理后派发给各个对象,再在构造函数中读取子串。但是最后每个对象都要写解析逻辑,代码重复度高,我出于厌恶又给推翻了。

最终1的设计是一套被动声明系统:每个需要配置的类只需声明一个 Schema,不用实际负责解析字符串。接收字符串的组件负责统一采集所有的 Schema,照着里面的指示将字符串中对应部分解析出来填入对象的指定域。为了简化声明的表述,我还额外开发了一套 DSL2,甚至连「有朝一日会出现 AI」这样的可能性都考虑进去了,让 Schema 里的每一项都可以附加元数据,帮助 AI 理解配置的逻辑与可调范围。八年来已经有无数的核心业务逻辑堆砌在这个底层组件上面,目前看来这个架构仍然稳如泰山,而且居然跑赢了时代,让现在接入 AI 自动配置成为可能。这算是我感到自豪的一次架构迭代。

而在这次经验中,我学到了很多架构的技巧(比如函数式编程的思维)。其实这些技巧和理论早就都写进了教科书,普通的软件工程的学生可能都在课上听过。但是,没有撞到南墙,是不知道北边为什么才是出路的;没有见证过一种架构的崩溃,就不能深刻到另一种架构或理论为什么重要。


「失败乃成功之母」——这不是一句安慰人的鸡汤文,而是一个事实:

  • 失败的经验比成功的结果要更值钱!
  • 失败的经验比成功的结果要更值钱!
  • 失败的经验比成功的结果要更值钱!

为什么科技界在大量裁员的同时,各个公司都在亿万美元疯抢 AI 人才?其实大家在疯抢的,除了好用的脑子之外,更重要的是「哪些道路试过行不通」的经验!道理很简单:在 AI 这个光速迭代的时代,走上一条歪路导致的时间和算力的损失都是不可估量的。

失败的经验远比成功的经验多,但是失败的记录却远比成功的记录要少。很少有人会发表「失败经验」的论文,都是悄悄把失败装在脑子的角落里,然后很可惜,大部分人就会把更值钱的这部分渐渐遗忘掉。

在「数据就是一切」的 AI 时代,「没有被充分分享的失败经验」意味着什么呢——每个人不被 AI 替代的价值之所在吧!

Footnotes​

  1. 希望如此吧。 ↩

  2. Domain Specific Language,就是在一种编程语言中创造另一种小方言。 ↩

酷炫的 ANSIWAVE BBS

· 阅读需 95 分钟
░
■▄▄ ▓▄▄▄ ░ ░░ ▄ ▀▀▀▀▀■
░ ▀▀▀▀▀▀▓▓▄▄▄ ░░▄ ▄▄▄▓▓▄▄▄▄▄▄▄▄▄▄■ ■▓▓█ ▌▌
▓ █████▄■ ▄▄▄▄▄ ▄▄▄ ▀ ▄▄▄▄▄▄▄▄▄▄░▀▀▀▀ ░░▀
▄▌░ ▓▓█▀█▓▓▓ ▓▓█████▓▓█▌ ▓▓▓██▀██▓██ ▓▓██ ▄▄ ▄
▀▄░▀ ▄▄▄▄███▓ ▓██████████ █████▄▄▄▄▄ ████ ▄▄ ░
▀ ▓ ░ ▄▓▓▓▓▓▓▓▓▒░▒▓▓▓▓▓▓▓▓▓▓░░▀▀▀▓▓▓▓▓▓▒ ▓▓▓▓ ▀▀ :
▄ ░ ▓ ▒▒▒▒▄▄▒▒▒░▒░▒▒▒▒ ▒▒▒▒▒▒▒▒▒▒▒▒▒▒▒▒░░▒▒▒▒ ░░ ▄
▬ ▒ ░░░░░▒▒▒░ ░░░░ ░░░░░░░░░░░░░░░░ ░░░░ ▓▒▒▄▀▄ ▄
░░▄ ░░_▀▀▀▀▀▀▀▀▀ ▀▀▀▀▀ ▀▀▀▀▀▀▀▀▀▀▀▀▀▀▀ ▀▀▀▀ ░░ ▀░░▄
▀█ █████ ▬ ▀▀▀ ████▀▀▄▄ ▄▄▀██ ▀▀███ ▄▀███████▄ ▀▓ ▒
▀■█ █████ ▓▓ ▀▀▀ ███▀████▓ █████ █████ ▀████▄▀▀███▀ ░ ▄
█ ░░░░░ ░░ ░░░ ░ ▄▄▄░░░░░▒░░░░░ ░░░░░▒░░░░░░░░░░░░ ▀
■ █ ▒▒▒▒▒ ▒▒▒▒▒▒░▄▒▒▒▒▒▒▒▒▒░▒▒▒▒▒ ▒▒▒▒▒░▒▒▒▒▒▒▒▒▒▒▒▒ ▌ ░
▄ ░ ▓▓▓▓▓▓▓▓▓▓▓▓▒▓▓▓▓▄▄▓▓▓▓ ▓▓▓▓▓▄▓▓▓▓▓ ▓▓▓▓▄▄▄▄▄▄ ▄ ▀▓ ▓
▒ ▀██████████▀ ██████████ █████████▌ ▀█████████ █ █ ▒
░ ▓▄ ▀▀▀▀▀▀▀▀ ▀▀▀▀▀▀▀▀▀ ▀▀▀▀▀▀▀▀ ▀▀▀▀▀▀▀▀ ▀ ▀
▀▄▀▓▄ ▄ ▒ ▓▄ ▄ ▄▀
▀▄▒ ░▒▓██████▀ ▓▓ ▓▓███░░ ░▀▀▀▀ ▀▀▀▀▀ ▀■▄▄▄▄ ▄▄▄▀▄▀
░ ▀ █ ▒ ░▀▀▀▀▀▀▀▀▀▀▀▀ ▀▀▀▒▀
▄ ░
ASCII Art

为了贴上这个 Logo 真是费死我的劲了! 😵‍💫 这可不是一张截图,而是 ASCII Art!你可以当作文字复制下来的哦~(但是不能粘贴 😅)

证据就是本文的「阅读时间需 95 分钟」!

RSS 阅读器应该没办法正确显示上面的图片,请移步到网页版看看~

前几天发现了这个超级酷炫但没用的软件——ANSIWAVE BBS(源代码)。

  • 可以发 BBS 帖!
  • 支持 ASCII Art 的正确显示(仅限桌面浏览器,手机的字体不行;现代技术都会肆无忌惮地破坏以前的兼容性)
  • 可以在帖子里直接写谱子,转换成 MIDI 放出来(估计现代技术又不行吧)
  • 无需创建账号——所以的账号就是一张含有私钥 QR Code 的 PNG 图片。只要有图,就有账号
  • 整个 BBS 的数据都可以放在 Git Repo 里,clone 一下就能把整个 BBS 数据载回家离线看
  • 使用特别小众的 Nim 语言写成

纯粹觉得这个项目真是太酷啦~

删网

· 阅读需 2 分钟

最近又删除了一批我遗留在互联网上的账号。

  • LinkedIn:我十几年没换过工作,页面从来不更新,猎头给我发信息我都是直接删除,半年登录一次。但主页上却有我的大头照、全部经历、全部社交圈。不删简直就是冤大头。
  • MuseScore.com:我还是蛮喜欢 MuseScore.com 的社交圈的(喜欢作曲的人群交往起来很舒服),也曾经得到了很多实质的帮助。不过我已经五年没作曲了,之后把作品搬到自己的小站上来充实一下吧。那边暂时变成全隐身状态。
  • Reddit:这是我时不时会注册账户去逛的地方,一般是满足一些阶段性的需求。任务完成之后就删账号,之后再重开,这应该是 Redditor 的常规操作了吧。
  • YouTube:我已经下架(设私密)了绝大多数的视频。我已经不太使用 YouTube 了,越来越不喜欢视频这种「线性时间需求」的媒体。
  • OpenAI:我发现 ChatGPT 对我毫无帮助。我一般用 Openrouter 路由到 Google Gemini。如果需要写代码的话就是 Claude。ChatGPT 的几个额外功能现在都用不到了(语音、图片、视频)。我一向超不爽 Sama 的厚颜无耻,碰巧又赶上最近的战争部争议,删账号走人。

我是一个超怀旧的人,扔一张孩子的草稿纸都想要先扫描起来。但不知为什么删号走人的时候居然都能做到「挥一挥衣袖,不带走一片云彩」的洒脱(因为根本没人关注嘛)。

忍不住测量了一下

· 阅读需 3 分钟

今天忍不住测量了一下。🤡

打开了 nginx 的访问日志文件 access.log 看了一眼访客到底长什么样子,结果发现了很多意料之外的东西:

访问量最高,一天能读几千次的 IP 地址,是试图破解 WordPress 的扫描器,对各种常见 .php 访问点就是一顿狂扫。另一种是对常规的 nodeJS 工程目录里敏感文件的扫描,比如 .env。这再次提醒我们,在互联网上开设服务器是一项危险的操作,一定要有基本的防护概念!

应对扫描器

我用 AI 快速生成了一个 fail2ban 规则:对于 10 分钟内两次触发 404 错误的 POST 操作,IP 就会被封禁 1 个小时。好奇的话可以试试看哦,亲测有效 🤗

我个人是不太喜欢 WordPress,除去复杂性带来的安全漏洞之外,我主要是不喜欢「文章放在数据库」里的逻辑错配。「文章」就应该是「文件」啊,否则太容易损毁了吧。

至于评论数据,最好的方式是邮件或者 Webmentions(暂时还没开始搞,不过已经加入 TODO)。

接下来我找到了若干个爬虫,现已招来 Meta、Google、OpenAI 这几个大头的机器人,而且 Meta 派出的那只居然爬到了我的草稿区(秘密是怎么被泄露的呢 🤔),还有几个简中博客聚合网站的爬虫和在线 RSS 订阅器的爬虫。其中 Feedly 会在 HTTP 代理人信息里贴心地告诉你它在为几个订阅者爬(我的小站是 "7 subscribers"🫶)。

让我开眼的是记录里大量不同 Fediverse 站点的机器人。我不知道我的小站是怎么被连到了 Fediverse 上(应该是哪位客官给共享到了自己的站点吧)。虽然不清楚这么多 Fediverse 的机器人们是来干什么的,不过这传播的速度的确让我惊奇。

剩下的看起来就是个人订阅者了,感谢各位人类莅临指导 ❤️ 我非常粗略地数了一下,一天大概至少有三五十人会路过这里。

以上就是我今天自己抽自己耳光的测量结果,顺便用结果加固了一下服务器1。如果你还没听说过 fail2ban 的话,记得一定要学着用起来,不要让服务器在危险的互联网上裸奔啊!

Footnotes​

  1. 不过这次测量的确给我带来了一些改变,也没算违反我之前文章里提到的原则 🤗 ↩

断网的权限

· 阅读需 2 分钟

Graphene OS 有一个特别的设计:App 要连接网络,需要授权。

想来真是挺可悲的——今天的大众手机操作系统里(iOS 以及 Android 12+),什么访问电话、通讯录、蓝牙、GPS、相册、文件夹等等都是可以撤销的权限,唯独「联网」这个最最重要的「门神」却不是一个可以禁止的权限。这到底是为什么?除了满满的恶意之外,我是想不到什么其他的解释了。

这就好比你买了新房子,拿到了床头柜的钥匙、五斗橱的钥匙、文件柜的钥匙、八音盒的钥匙,甚至还赠送了一本带锁的日记本给你,美其名曰「注重安全隐私的新时代住宅」——但唯独大门是没有钥匙的,因为根本不让你上锁。

最近 Google 强迫所有安卓应用程序的创作者实名认证的政策又被若干个企业和实体联名写公开信抨击——看来大门是能上锁的,只是钥匙根本不在你的手里。

一个大门钥匙掌握在警察局长手里的房子,会让人觉得这是一个「安全温馨的家」吗?估计只有警察局长自己这么觉得吧。

相反,如果你有一扇皮实的大门,钥匙掌握在你自己的手里,那五斗橱还要上锁干什么?一个不能联网的 App,我可以毫无顾忌地开放其他一切权限给它。我用搜狗的输入法,Google 的相册,网上随便找来的录音笔记程序——就算知道它们都可能有一个偷窥狂主子,我也完全不担心,因为它们都连不了网(从道理上讲这些应用程序也不根本需要网络啊)。

光凭这一点,Graphene OS 对于我就是一个无可替代的操作系统。讽刺的是,为了在软件上对抗 Google,你必须先得掏钱买 Google 的硬件(Graphene OS 只能用在 Pixel 系列硬件上)。

但是好消息

摩托罗拉与 Graphene OS 达成了合作协议1,也许很快就能买到支持 Graphene OS 的摩托罗拉手机啦!

Footnotes​

  1. https://motorolanews.com/motorola-three-new-b2b-solutions-at-mwc-2026/ ↩